数据速览
- 同电力预算运行节点(原 16)
- 19 个
- 集群 token 吞吐
- 约 +24%
- 每瓦性能
- 约 +23%
- Rubin 同兆瓦多装 GPU(投影)
- 最多约 40%
云厂商 Lambda 首次在 NVIDIA HGX B200 上验证 DSX MaxLPS:原先约 16 个满功率节点的电力预算内,跑了 19 个节点。集群 token 吞吐从约 400 万升到约 500 万 tokens/s(约 +24%),每瓦性能约 +23%。NVIDIA 2026 年 9 月 15 日在博客公布这组由合作方给出的数据,同场 Ian Buck 在 AI Infra Summit 上把 AI 工厂能效与每瓦 token 产出放到台前。
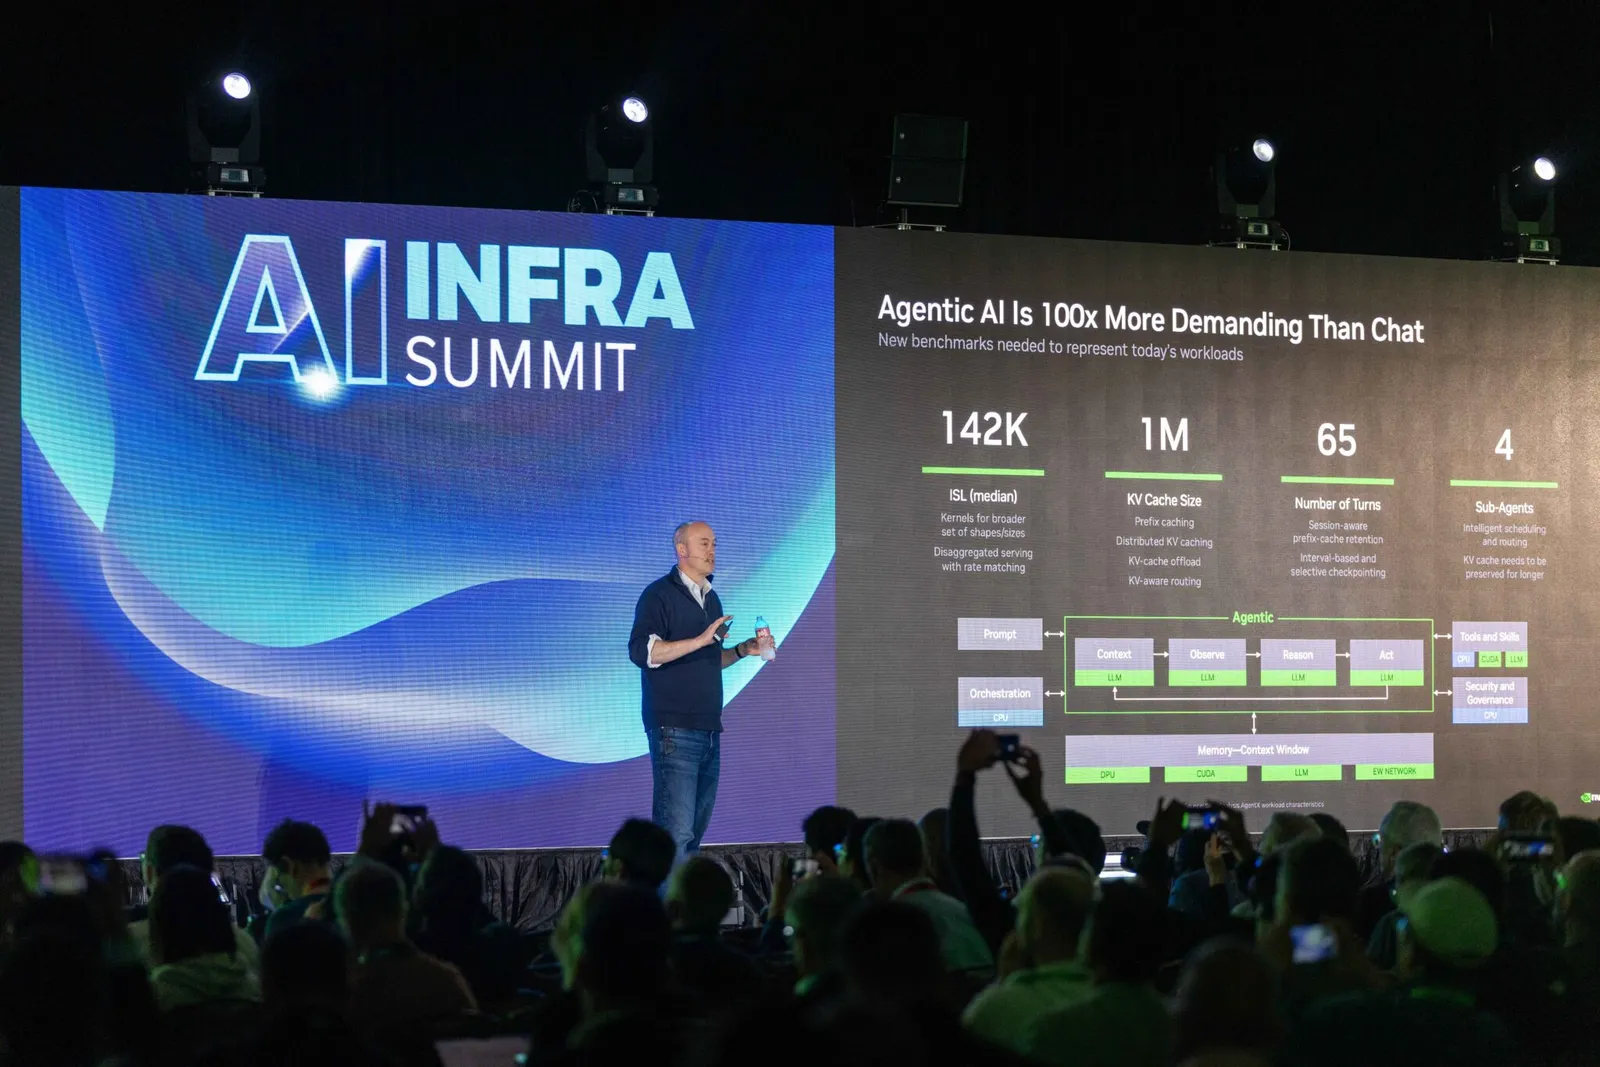
NVIDIA 另称,在合适部署下,该软件可让下一代 Vera Rubin NVL72 在相同兆瓦预算内多装最多约 40% 的 GPU。厂商投影的上限是约 1.4x tokens/MW。这些数字来自厂商与合作方验证,尚无第三方独立复现。
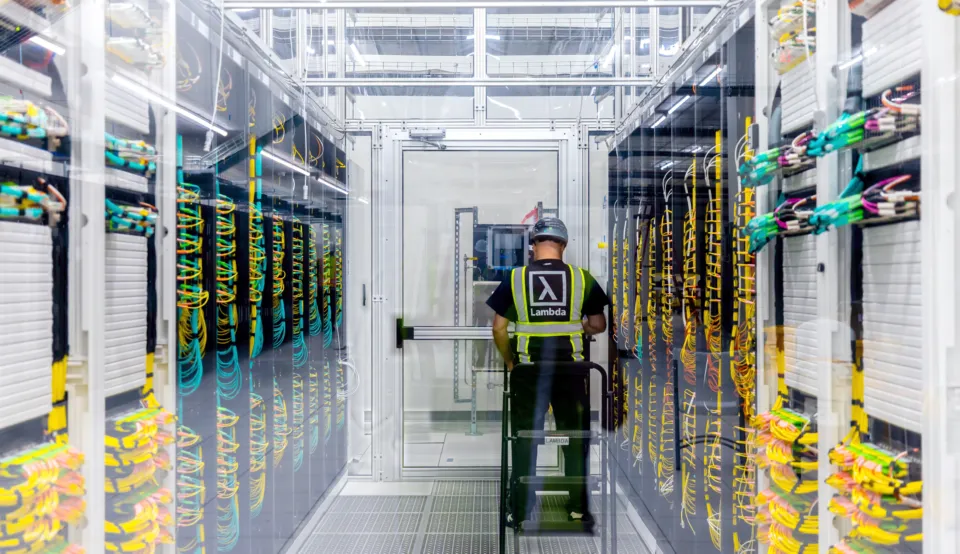
机制上,跨 GPU 与机架持续监测功耗,按负载类型把余量再分配出去,把静态按峰值预留、实际吃不满的供电闲置容量收回来。训练吃电呈脉冲,推理把空隙填上;混跑时才有东西可回收。Lambda 案例页给出五机架、19 节点,并注明 85% 功率策略对应 16 节点满功率基线。
机房供电按峰值功耗预留,而负载多数时间达不到峰值,这部分闲置容量是新建电源之外最快能拿到的增量。并网周期拉长后,同一兆瓦里能产出多少 token,开始和单卡性能一起进入采购比较。投影中的 40% 与 1.4x 取决于具体机房的负载构成。
TAGS#NVIDIA#DSX#Lambda#数据中心