数据速览
- 紧耦合国产 AI 芯片
- 128 颗
- 统一编址显存
- 8 TB
- 芯片间通信时延
- 0.69 微秒
- Kimi K3 单用户生成速度
- 约 170 Token/s
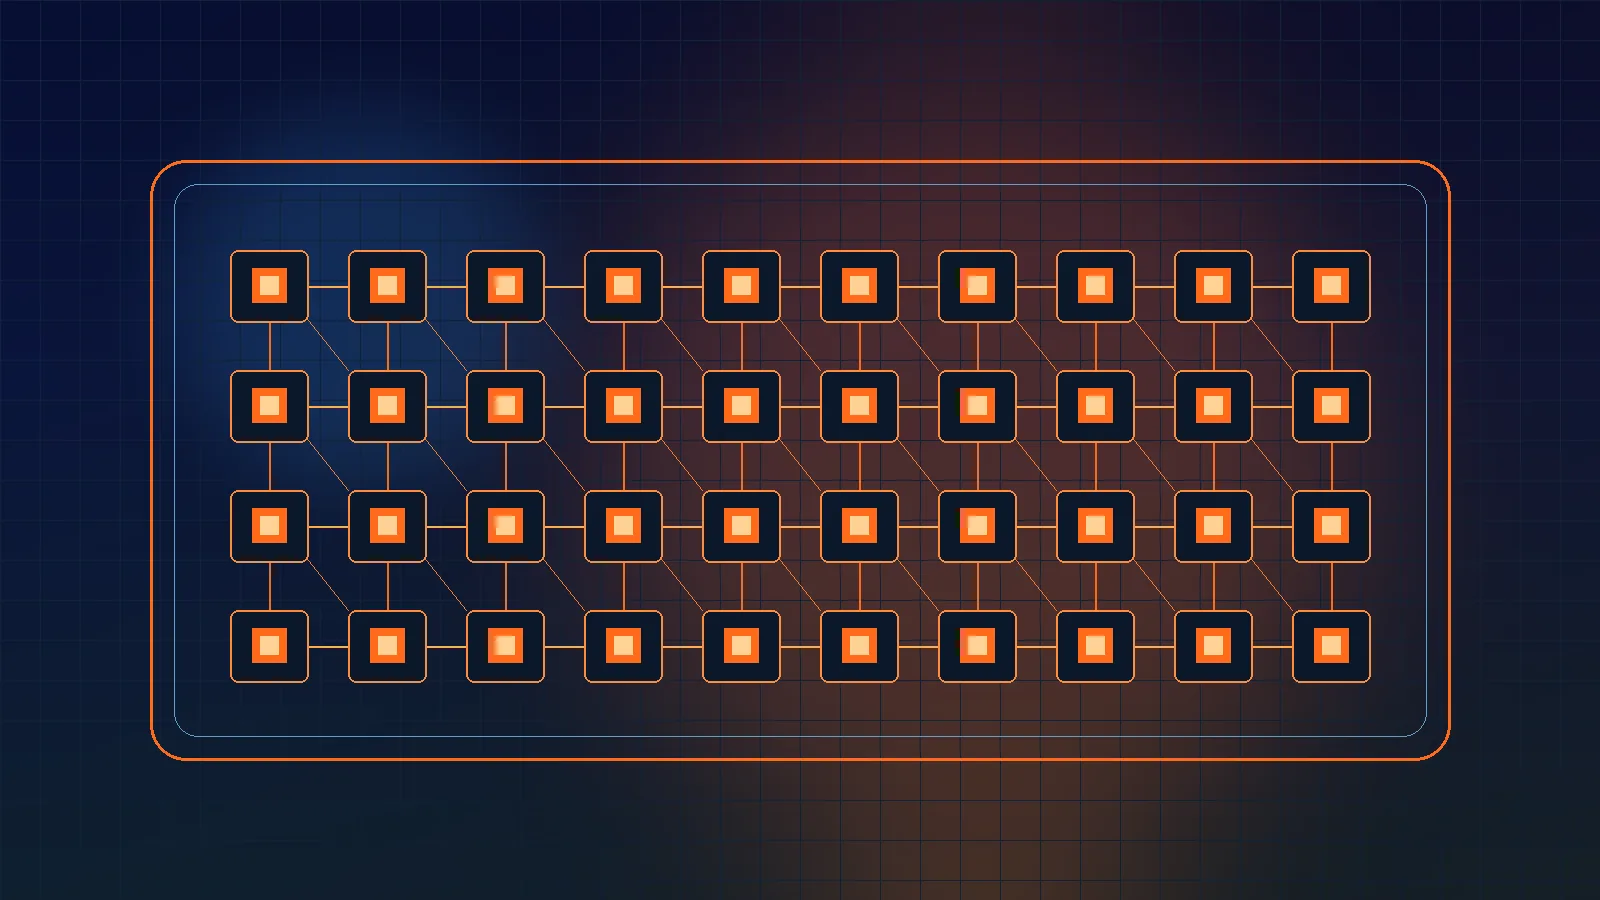
浪潮信息 9 月 21 日在人工智能计算大会(AICC)上发布超节点服务器元脑 SD200 Ultra,同场推出多元算力机组 HC2000。SD200 Ultra 用 128 颗国产 AI 芯片做紧耦合,组成一台逻辑上的单机。
显存统一编址,总量 8 TB,另配 64 TB 内存。芯片之间的互联架构名为 3D Hyper Mesh,通信时延 0.69 微秒。浪潮称,这是对称内存首次用在国产 AI 芯片超节点上,一颗芯片可以直接读取另一颗的显存。据厂商数据,AllReduce 通信耗时因此降低 3.5 倍。
模型侧,浪潮称这台机器可单机运行 2.8 万亿参数的 Kimi K3。每个 Token 的生成时延压到 5.85 毫秒以内,折合单用户每秒约 170 个 Token,厂商称生成速度约为业界平均的 5 倍。针对 Kimi K3,浪潮还做了算子层合并,把 KDA、Gated MLA 与 MoE 里的基础算子收拢。算子数量约减少到原来的十分之一,推理性能提升 3 倍以上。
HC2000 包含 DirectCom 2.0、高密液冷整机柜和软件栈 MCIS。厂商称,同样投资下的 Token 产能约提升 10 倍。以上时延与倍数均为厂商数据,尚无第三方测试。
单颗国产芯片的显存和带宽仍不及海外旗舰,万亿参数模型的推理只能靠多芯片拼成大内存池来承载。超节点把互联做进一台机器,是国产算力绕开单卡差距的主要路线。SD200 Ultra 的实际表现,要看客户部署后的吞吐与稳定性数据。
TAGS#浪潮信息#元脑#超节点#Kimi